 9tee
คำตอบก่อนเข้าตัวเลข: ถ้างานหลักของคุณคือ coding agent ที่วิ่งทั้งวัน และคุณดูบิล API ทุกเดือน Kimi K3.1 Pro คือตัวที่น่าทดสอบจริงจัง ความสามารถรวมอยู่ใกล้ Claude Opus 5.5 มาก ในขณะที่ราคาต่อโทเคนเป็นครึ่งหนึ่ง ถ้างานคือการวิเคราะห์เชิงลึก งานสายวิทยาศาสตร์ หรือคุณอยากได้โมเดลที่ผ่านสนามจริงมานานกว่า Claude Opus 5.5 ยังเป็นคำตอบที่ปลอดภัยกว่า และถ้าเป้าหมายคือ self-host ให้จับตา 4 พฤศจิกายน 2026 วันที่ Moonshot นัดปล่อย weights ของ K3.1 Pro
บทความนี้รวบตัวเลขที่เทียบกันได้ ณ 24 ตุลาคม 2026 จากตารางของผู้ผลิตทั้งสองฝ่ายและผลวัดของผู้ประเมินอิสระ พร้อมระบุชัดทุกจุดว่าตัวไหนยังสรุปไม่ได้
รู้จักสองตัวก่อนเทียบ
Kimi K3.1 Pro คือรุ่นใหม่ล่าสุดของ Moonshot AI เปิดตัวเมื่อ 23 ตุลาคม 2026 และใช้งานได้บน Kimi.ai, Kimi Work, Kimi Code และ API ในวันถัดมา ตัวโมเดลเป็นการ post-training ต่อจาก Kimi K3 ด้วยงบ reinforcement learning ที่มากขึ้น ไม่ใช่สถาปัตยกรรมใหม่ Moonshot อธิบายขนาดแบบกำกวม ๆ ว่า "3T-class" โดยรายงานจากภายนอกระบุประมาณ 2.8 ล้านล้านพารามิเตอร์แบบ MoE ทำงานจริงราว 104 พันล้านตัว รองรับ context 1 ล้านโทเคน รับทั้งข้อความ รูปภาพ และวิดีโอ มีรุ่นเสริมชื่อ K3.1 Pro Highspeed ที่ output เร็วขึ้นประมาณ 2–3 เท่าแต่กินโควต้าราวสองเท่า
Claude Opus 5.5 ของ Anthropic เปิดตัวไปแล้วเมื่อ 22 กันยายน 2026 เป็นรุ่นเรือธงที่ทีม dev หลายแห่งใช้สะสมผลงานมาแล้วราวหนึ่งเดือนก่อนรุ่นใหม่ของ Kimi จะมาถึง context 1 ล้านโทเคนเท่ากัน output สูงสุด 128K โทเคน
จุดที่คนพูดถึงมากที่สุดตอนเปิดตัวคือราคา K3.1 Pro ขายที่ 2 ดอลลาร์ต่อ input ล้านโทเคน และ 10 ดอลลาร์ต่อ output ล้านโทเคน ครึ่งหนึ่งของ Opus 5.5 ที่ขาย 4/20 ดอลลาร์ คำถามของบทความนี้คือ ในราคาที่ต่างกันเท่าตัว คุณภาพต่างกันจริงแค่ไหน
กติกาการอ่านตัวเลขชุดนี้
บทความเทียบโมเดลมักลงเอยด้วยการเอาตารางของผู้ขายมาเรียงใหม่ ชุดนี้ขอแยกที่มาให้ชัดก่อน เราไม่ได้ทดสอบทั้งสองโมเดลด้วยตัวเอง ตัวเลขทั้งหมดจึงมีสองชนิด: ตารางที่ผู้ผลิตรายงานเอง และผลวัดจากผู้ประเมินอิสระอย่าง Artificial Analysis ทุกตัวเลขด้านล่างบอกที่มาไว้ในประโยค
เรื่องที่ต้องรู้ก่อนอ่านคือ เลข Terminal-Bench 4.0 ซึ่งเป็นตารางเดียวที่ทั้งสองบริษัทให้มา ไม่ได้ผลิตในเงื่อนไขเดียวกัน Moonshot วัด K3.1 Pro ที่ reasoning effort ระดับ max ซึ่งเป็นค่า default ของโมเดล ผ่าน harness ของ Claude Code (ตาม footnotes ในหน้าเปิดตัวของเขาเอง) ส่วนเลข 66.4% ของ Opus 5.5 มาจาก harness ของ Anthropic ที่ effort ระดับ xhigh ซึ่งสูงกว่า default หนึ่งขั้น ระยะ 0.7 แต้มที่คนชูกันจึงไม่ใช่การวัดความต่างของโมเดลในเงื่อนไขเดียวกัน มันบอกได้แค่ว่าสองตัวนี้ใกล้กันมากจนวิธีตั้งค่าการทดสอบเป็นตัวตัดสินลำดับ
อีกสองจุดที่ควรจำ: เอกสาร API ของ Moonshot วันเปิดตัวยังมีช่องว่าง placeholder อยู่บางแถว และทั้งสองค่ายยังไม่ปล่อยเลข SWE-bench ซึ่งเป็นเบนช์มาร์กที่ทีม dev อ้างกันมากที่สุด ตรงนี้เราถือว่า "ยังไม่ทราบ" ไม่ใช่ศูนย์
ตารางความสามารถที่เทียบกันได้
| Kimi K3.1 Pro | Claude Opus 5.5 | |
|---|---|---|
| เปิดใช้งาน | 24 ต.ค. 2026 | 22 ก.ย. 2026 |
| ราคา input / 1M tok | $2.00 | $4.00 |
| ราคา output / 1M tok | $10.00 | $20.00 |
| Cache read / 1M tok | $0.20 | $0.20 |
| Cache write (5 นาที / 1 ชม.) | $2.00 / $4.00 | $5.00 / $8.00 |
| Context | 1,048,576 tok | 1M tok |
| Output สูงสุด | ~943K tok | 128K tok |
| Reasoning effort | low / high / max (default: max) | low ถึง max 5 ระดับ (default: medium) |
| ควบคุม sampling | ล็อก temp 1.0, top-p 0.95 | ปรับ temperature ได้ |
| โหมดเร็ว | Highspeed $4/$20 เร็วขึ้น ~2–3× | Fast $8/$40 เร็วขึ้นสูงสุด 2.5× |
| Open weights | นัดปล่อย 4 พ.ย. 2026 | ไม่มีแผนประกาศ |
ตัวเลข output สูงสุดฝั่ง Kimi (~943,718 โทเคน) มาจากหน้าวัดของ Artificial Analysis ส่วนราคาทั้งหมดเป็น snapshot วันที่ 24 ตุลาคม 2026 อาจเปลี่ยนได้
ผล benchmark: ใกล้กันกว่าที่หัวข้อข่าวบอก
ภาพรวมจากผู้วัดอิสระ
Artificial Analysis วัด K3.1 Pro ได้ 55 คะแนนบน Intelligence Index เวอร์ชัน 4.3.2 อันดับ 4 จาก 215 โมเดล ขณะที่ Opus 5.5 อยู่ที่ 58 ระยะ 3 คะแนนบอกทิศทางเดียวกับตารางผู้ผลิต คือ Opus ยังนำ แต่นำแบบไม่หลุดโผ (GPT-6 Astra อยู่ที่ 53)
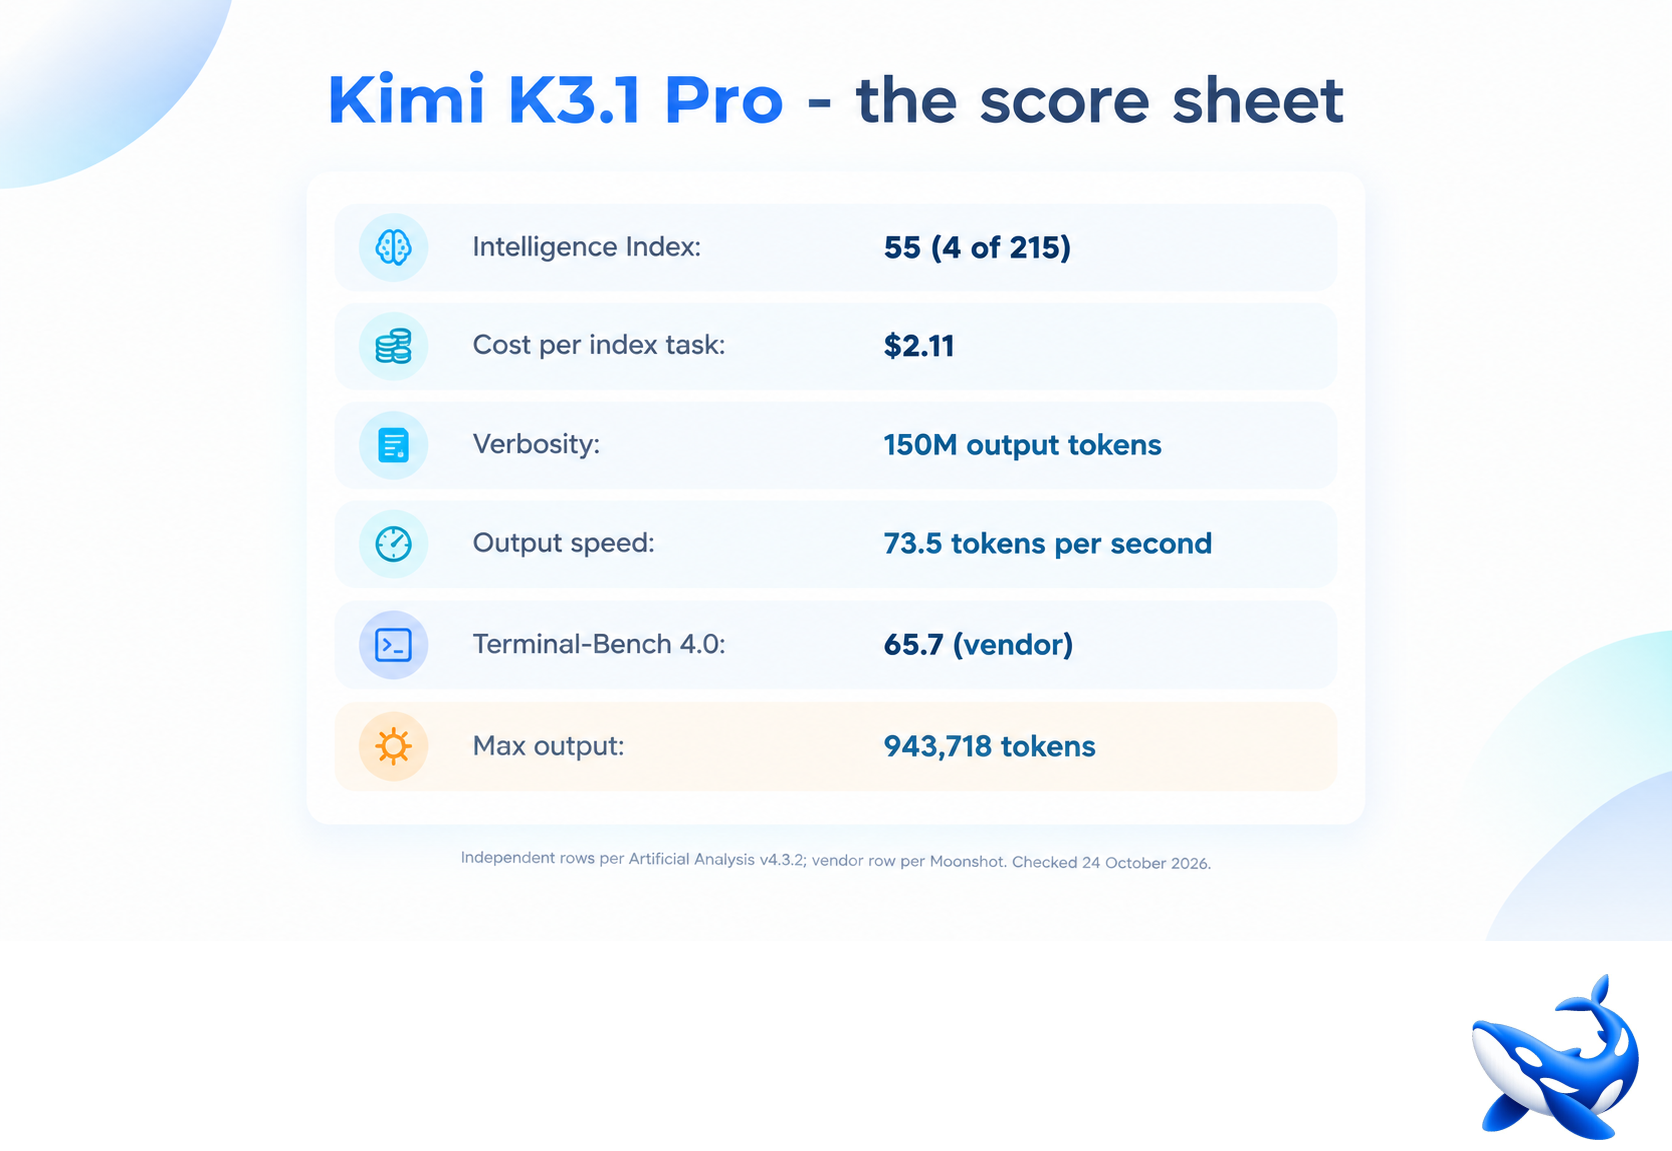
ภาพ: หน้าวัดของ Artificial Analysis (ผ่าน OrcaRouter) ตรวจข้อมูล 24 ต.ค. 2026
สิ่งที่น่าสนใจจากหน้าวัดเดียวกันคือนิสัยการพูด ระหว่างวัด index โมเดลนี้สร้าง output 150 ล้านโทเคน ขณะที่ค่ากลางของวงการอยู่ที่ 87 ล้าน ทำให้ต้นทุนต่องานจริงขึ้นไปที่ 2.11 ดอลลาร์ต่อ task ความเร็ว output อยู่ที่ 73.5 โทเคนต่อวินาที ช้ากว่าค่าเฉลี่ยกลุ่มนี้เล็กน้อย เดี๋ยวกลับมาคุยเรื่องนี้ในหัวข้อราคา
งาน coding agent ตามตารางผู้ผลิต
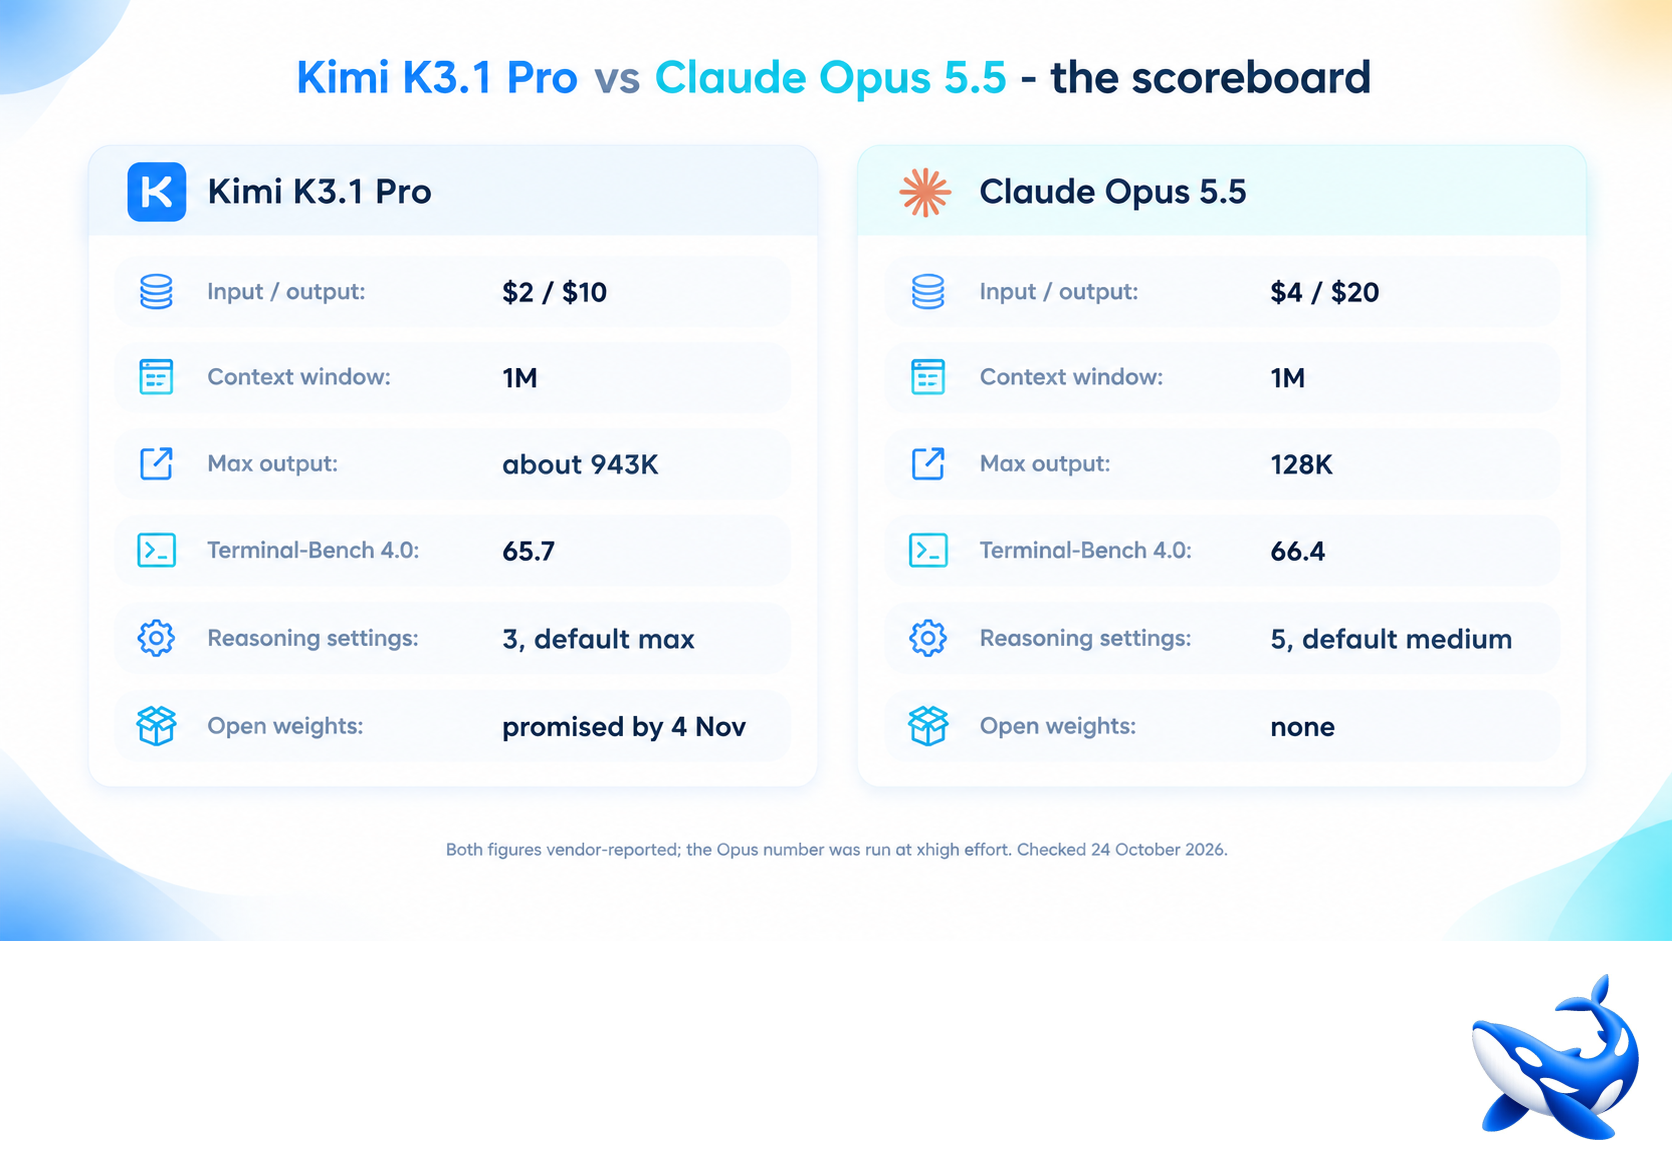
ภาพ: OrcaRouter — ราคาและเลข Terminal-Bench 4.0 ตามที่ผู้ผลิตรายงาน (ตรวจข้อมูล 24 ต.ค. 2026)
บน Terminal-Bench 4.0 ตารางของ Moonshot ให้เลข K3.1 Pro ที่ 65.7% เทียบ Opus 5.5 ที่ 66.4% และ GPT-6 Astra ที่ 58.2% แปลว่าจากมุมมองงาน coding agent แบบยาว ตัวใหม่ของ Moonshot ขึ้นมาอยู่ในกลุ่มเดียวกับ Opus และเหนือกว่า Astra ชัดเจน อ่านพร้อมข้อจำกัดจากหัวข้อก่อนหน้าได้เลย คนละ harness คนละ effort เลขนี้ใช้ตัดสิน "ว่าใกล้กัน" ได้ แต่ใช้ตัดสิน "ว่าใครเก่งกว่า" ยังไม่ได้
งานเฉพาะทางที่ควรอ่านละเอียด
งาน 3D/CAD จุดที่ Moonshot โปรโมตหนัก บน BenchCAD แบบมี tools K3.1 Pro ได้ 92.7% เทียบ Opus 96.2% และแบบไม่มี tools ได้ 72.8% เทียบ 73.0% แปลว่าแพ้ก็จริง แต่แพ้ในระยะที่แทบมองไม่เห็น
ความจำผิด (hallucination) ตารางของ Moonshot เองระบุว่า K3.1 Pro ให้คำตอบผิดข้อเท็จจริงระดับ claim ที่ 8.3% เมื่อมี tools เทียบ Opus ที่ 15.0% ดีกว่าชัด แต่ GPT-6 Astra ยังดีกว่าอีกที่ 5.5% ที่น่าสนใจกว่าคือเทียบกับตัวเองย้อนหลัง Kimi K3 เคยจำผิดถึง 23.4% รุ่นนี้ลดลงมาก
งานสายวิทยาศาสตร์ ตรงนี้ฝั่ง Opus มีเลขเผยแพร่ 58.7% บน Terminal-Bench Science 0.1 ขณะที่ Moonshot บอกแค่ว่า "เหนือกว่า K3" โดยไม่ให้ตัวเลข ตราบใดที่ไม่มีเลขสองฝ่ายในเงื่อนไขเดียวกัน เราถือว่าหัวข้อนี้ยังสรุปไม่ได้ แต่เลขเดียวที่มีอยู่ชี้ว่า Opus นำแบบกว้าง
อัปเกรดจาก K3 คุ้มไหม ถ้าใช้ K3 อยู่แล้ว ตารางของ Moonshot ให้ภาพเทียบกับตัวเองที่ดูสม่ำเสมอ: Kimi Code Bench long-horizon จาก 55.95% ขึ้นเป็น 61.2% งานการเงิน Financial Modeling จาก 50.4 ขึ้นเป็น 57.6 และ Business Operation จาก 8.9 กระโดดเป็น 37 จุดที่เก่าแทบใช้ไม่ได้
อีกเลขที่ Moonshot เปิดเผยเองและควรได้เครดิต: checkpoint เดียวกันที่ตัดมาตรการลดความเสี่ยง cyber ออกทำ xdev-bench-hard ได้ 90.5% ขณะที่ตัวที่วางขายจริงได้ 81.0% ความปลอดภัยมีราคาประมาณ 9.5 แต้ม และเขาเลือกจ่ายมัน
ราคา: ถูกครึ่งเดียวบนกระดาษ แต่จ่ายจริงอาจไม่ใช่ครึ่ง
ตารางราคาเทียบกันสวยมาก input/output ครึ่งตัว cache read ราคาเท่ากันพอดีที่ $0.20 cache write ฝั่ง Kimi ถูกกว่าด้วยซ้ำ ($2/$4 เทียบ $5/$8) แม้แต่โหมดเร็วก็เป็นความสัมพันธ์เดียวกัน Highspeed ที่ $4/$20 เทียบ fast mode ของ Opus ที่ $8/$40
แต่มีสองเรื่องที่ทำให้ "ครึ่งราคา" เลือนลงเวลาดูใบเสร็จ
หนึ่ง K3.1 Pro default คิดที่ระดับ max และตอบยาว ผลวัดของ AA ให้ต้นทุนต่องานจริงที่ 2.11 ดอลลาร์ต่อ task ซึ่งจัดอยู่อันดับ 85 จาก 113 ด้านความคุ้มค่า ขณะที่ Opus default ที่ระดับกลาง ถ้าย้ายงานมาโดยไม่แตะ effort เลย คุณเปลี่ยนทั้งโมเดลและงบการคิดพร้อมกัน ซึ่งเป็นวิธีที่ทำให้ "โมเดลถูก" กลายเป็นเรื่องที่ต้องวัดกันใหม่
สอง จากการวิเคราะห์ของ OrcaRouter agent ที่อ่าน context ยาวซ้ำทุกรอบกับ cache hit ราว 70% จ่าย input ราว $2.74 ต่อรอบฝั่ง Kimi เทียบ $5.34 ฝั่ง Opus ส่วนต่างจริงมาจาก input สดกับ output ไม่ใช่จาก cache เพราะ cache read ราคาเท่ากันทั้งคู่
ข้อควรระวังที่ใช้กับทั้งสองตัว: การสลับ effort กลาง conversation ทำ prefix cache ที่เก็บไว้ใช้ไม่ได้ทั้งก้อน ตั้งระดับตั้งแต่ต้นเซสชันดีกว่า และฝั่ง Anthropic เองก็แสดงว่า effort มีผลกับงานจริง CursorBench 4.0 ได้ 57.8% ที่ xhigh แต่เหลือ 52.5% ที่ medium
Open weights และเรื่องการผูกมัด
Kimi นัดปล่อย weights ภายใน 4 พฤศจิกายน 2026 นี่คือจุดขายที่ Opus ไม่มีเลย ใครวางแผน self-host ให้รอดูของจริงวันนั้น และเช็กสเปกเครื่องให้ดี เพราะ MoE ระดับหลักล้านล้านพารามิเตอร์ไม่ใช่ของที่เครื่องทั่วไปจะรันไหว
ด้านพฤติกรรม API K3.1 Pro ล็อกค่า sampling ไว้ที่ temperature 1.0 กับ top-p 0.95 ให้ปรับได้แค่ reasoning effort ตัวเดียว ส่วน Opus เปิด temperature ให้ปรับ แต่ adaptive thinking เปิดตลอดเวลา ทั้งคู่ไม่ให้ปิดการคิด ถ้า workflow ของคุณต้องการคุมความสุ่มละเอียด ๆ อ่านตรงนี้ให้ครบก่อนย้ายงาน
สรุปรายมิติ: ใครได้เปรียบตรงไหน
| มิติ | ตัวที่ได้เปรียบ | หมายเหตุ |
|---|---|---|
| ภาพรวม (ผู้วัดอิสระ) | Opus 5.5 | 58 เทียบ 55 |
| Coding agent (ตารางผู้ผลิต) | ใกล้เกินตัดสิน | 0.7 แต้ม คนละ harness และ effort |
| งาน 3D/CAD | Opus 5.5 | 96.2 เทียบ 92.7 (มี tools) |
| ความจำผิด (ตารางผู้ผลิต) | Kimi K3.1 Pro | 8.3% เทียบ 15.0% |
| Science | Opus 5.5 | อีกฝั่งไม่ปล่อยเลข = ยังสรุปไม่ได้ |
| ราคาต่อโทเคน | Kimi K3.1 Pro | ครึ่งตัวทั้ง input และ output |
| ต้นทุนต่องานจริง | ยังสรุปไม่ได้เต็ม | ต้องวัดกับงานจริงของแต่ละทีม |
| Open weights / self-host | Kimi K3.1 Pro | นัดปล่อย 4 พ.ย. 2026 |
| ประวัติการใช้งานจริง | Opus 5.5 | อยู่ในตลาดก่อนกว่าเดือน |
ควรเลือกตัวไหน
ส่วนนี้เป็นความเห็นของผม แยกจากตัวเลขด้านบน
ใครทำ coding agent งานประจำวันและจ่าย API เอง ผมมองว่า K3.1 Pro สมควรได้รับการทดสอบจริงจัง วิธีที่ดีที่สุดคือเลือกงานจริงของทีม 1–2 ชิ้น รันขนานกันสองฝั่งประมาณสองสัปดาห์ เก็บตัวเลขต้นทุนต่อ task ที่จบงานจริง ไม่ใช่ตัดสินจากการ์ดราคา เพราะความชอบตอบยาวของ Kimi กินส่วนต่างกลับไปได้
งานวิเคราะห์ลึก งานวิจัย หรือเอกสารที่ผิดไม่ได้ Opus 5.5 ยังมีหลักฐานรองรับมากกว่า ทั้งจาก index อิสระและจากการอยู่ในสนามมาก่อน
ใครวางแผน self-host ให้รอ 4 พฤศจิกายน แล้วรอผลวัดอิสระหลัง weights ออกจริงอีกชั้น
และถ้าใครกำลังใช้ GPT-6 Astra อยู่ ทั้งสามตัวอยู่ห่างกันแค่ไม่กี่คะแนน งานเฉพาะทางของทีมคุณสำคัญกว่า index รวมเสมอ
ข้อจำกัดของบทความนี้
เราไม่ได้ทดสอบสองโมเดลนี้ด้วยตัวเอง ทุกตัวเลขมาจากผู้ผลิตหรือผู้วัดอิสระตามที่ระบุไว้ในแต่ละหัวข้อ ยังไม่มีข้อมูล: เลข SWE-bench ของทั้งคู่ เลข science ฝั่ง Kimi และผลวัดอิสระที่ครบถ้วน เพราะตัวโมเดลเพิ่งขึ้นเว็บเมื่อวาน ราคาและเงื่อนไขทั้งหมดเป็นข้อมูลวันที่ 24 ตุลาคม 2026 เราจะอัปเดตบทความนี้เมื่อ weights ออกจริงและมีผลวัดอิสระเพิ่มเข้ามา
Sources
- ประกาศเปิดตัว Kimi K3.1 Pro (Moonshot): https://www.kimi.ai/blog/kimi-k3-1-pro
- เอกสารโมเดลของ Kimi Code: https://www.kimi.com/code/docs/en/kimi-code/models.html
- OrcaRouter — สำรวจทุกตัวเลข benchmark ของ K3.1 Pro: https://www.orcarouter.ai/blog/kimi-k3-1-pro-benchmark
- OrcaRouter — เทียบ K3.1 Pro กับ Opus 5.5: https://www.orcarouter.ai/blog/kimi-k3-1-pro-vs-claude-opus-5-5
- Kingy.ai — วิเคราะห์วันเปิดตัว K3.1 Pro: https://kingy.ai/blog/kimi-k3-1-pro-launch-features-benchmarks-access/
- Artificial Analysis — หน้าวัด Kimi K3.1 Pro: https://artificialanalysis.ai/models/kimi-k3-1-pro
ความคิดเห็น