 9tee
ถ้าดูจากเลขรุ่น GLM-5.3 เราอาจคิดว่า Z.ai เปลี่ยนสถาปัตยกรรมหรือฝึก base model ใหม่อีกรอบ แต่ประกาศเปิดตัววันที่ 14 สิงหาคม 2026 ระบุชัดว่า GLM-5.3 ใช้ base model เดียวกับ GLM-5.2 ความสามารถที่เพิ่มขึ้นมาจาก Post-training ทั้งหมด
Post-training คือการฝึกต่อหลังจากโมเดลเรียนรู้ภาษาจากข้อมูลจำนวนมากแล้ว รอบนี้ Z.ai เพิ่มสภาพแวดล้อมสำหรับ Reinforcement Learning (RL) ให้หลากหลายขึ้น ใช้งานจริงขึ้น และยาวขึ้น บางโจทย์จำลองงานวิศวกรรมที่คนมีประสบการณ์อาจใช้เวลาหลายวัน ต่างจากโจทย์เขียนฟังก์ชันสั้น ๆ
ประเด็นสำคัญอยู่ที่ Post-training บนสภาพแวดล้อมซึ่งตรวจคำตอบได้ อาจยกระดับ Coding Agent ได้มากโดยไม่ต้องเปลี่ยนโมเดลฐานทุกครั้ง ส่วนผลด้าน Cybersecurity เตือนว่าความสามารถใหม่มาพร้อมความเสี่ยงด้วย
GLM-5.3 เปลี่ยนอะไรจาก GLM-5.2
Z.ai สรุปการเปลี่ยนแปลงไว้สามด้าน
- Coding และงาน Agent ระยะยาวดีขึ้น โดยเฉพาะโจทย์ที่ต้องวางแผน ใช้เครื่องมือ แก้หลายไฟล์ และตรวจผลต่อเนื่อง
- ความสามารถด้านการค้นหาและใช้ประโยชน์จากช่องโหว่สูงขึ้นเร็วกว่าที่ทีมคาด
- เตรียมเปิด weights สู่สาธารณะ แต่ยังไม่ปล่อยในวันเปิดตัว บริษัทกำหนดรออีกสองสัปดาห์เพื่อทำ Safety Evaluation และ Hardening
ข้อสามสำคัญ เพราะคำว่า Open Source หรือ Open Weights ในประกาศไม่ได้แปลว่าดาวน์โหลดโมเดลได้ทันที ณ วันเปิดตัว ผู้ที่ต้องการรัน GLM-5.3 ในเครื่องตัวเองยังต้องรอการปล่อย weights และรายละเอียด License อีกครั้ง
Post-training รอบนี้ไม่ได้เพิ่มแค่ข้อมูลคำสั่ง
Z.ai อธิบายว่าทีมขยายสภาพแวดล้อมฝึกให้ใกล้กับงานจริงมากขึ้น ตัวอย่างหนึ่งคือโจทย์ด้าน ML Infrastructure ซึ่ง Agent ต้องเข้าถึง Cluster, Storage, เอกสารภายใน, Codebase และผลการทดลอง จากนั้นวิเคราะห์คอขวด แก้ระบบ รันการทดลอง และพิสูจน์ว่าเร็วขึ้นโดยไม่ทำให้ผลลัพธ์ผิด
โจทย์แบบนี้ต้องมีตัวตรวจที่น่าเชื่อถือ ไม่เช่นนั้นโมเดลอาจเรียนรู้วิธีเอาคะแนนโดยไม่ได้แก้ปัญหาจริง Z.ai จึงใช้ Pipeline สร้าง Environment และ Verifier โดยให้ Judge Agent ทดสอบว่าโจทย์แก้ได้จริง พร้อมตรวจกรณี Oracle, No-op และสถานะที่ยังแก้ไม่สำเร็จ ก่อนนำ Reward ไปใช้ฝึก
โครงสร้างพื้นฐานเดิมจาก GLM-5.2 ยังถูกนำมาใช้ต่อ ได้แก่การจัดการ Long Context, Single-Rollout Asynchronous Optimization (SAO) สำหรับ Agentic RL และ slime ซึ่งเชื่อม Megatron ฝั่ง Training เข้ากับ SGLang ฝั่ง Rollout ใน Dataflow เดียว
บริษัทระบุว่าการปรับ Scheduling, Load Balancing และระบบ Cache ช่วยเพิ่ม Throughput การฝึก RL สำหรับงาน Coding ระยะยาวมากกว่า 2.3 เท่า ตรงนี้อธิบายว่าทำไมทีมจึงเพิ่มจำนวนและความซับซ้อนของ Environment ได้ โดยไม่ต้องสร้าง Training Stack ใหม่ทุกครั้ง
Benchmark ดีขึ้นตรงไหน
คะแนนที่ Z.ai เลือกมาแสดงชี้ว่ารุ่นใหม่ดีขึ้นชัดเจนกว่ารุ่นก่อนในหลายงาน
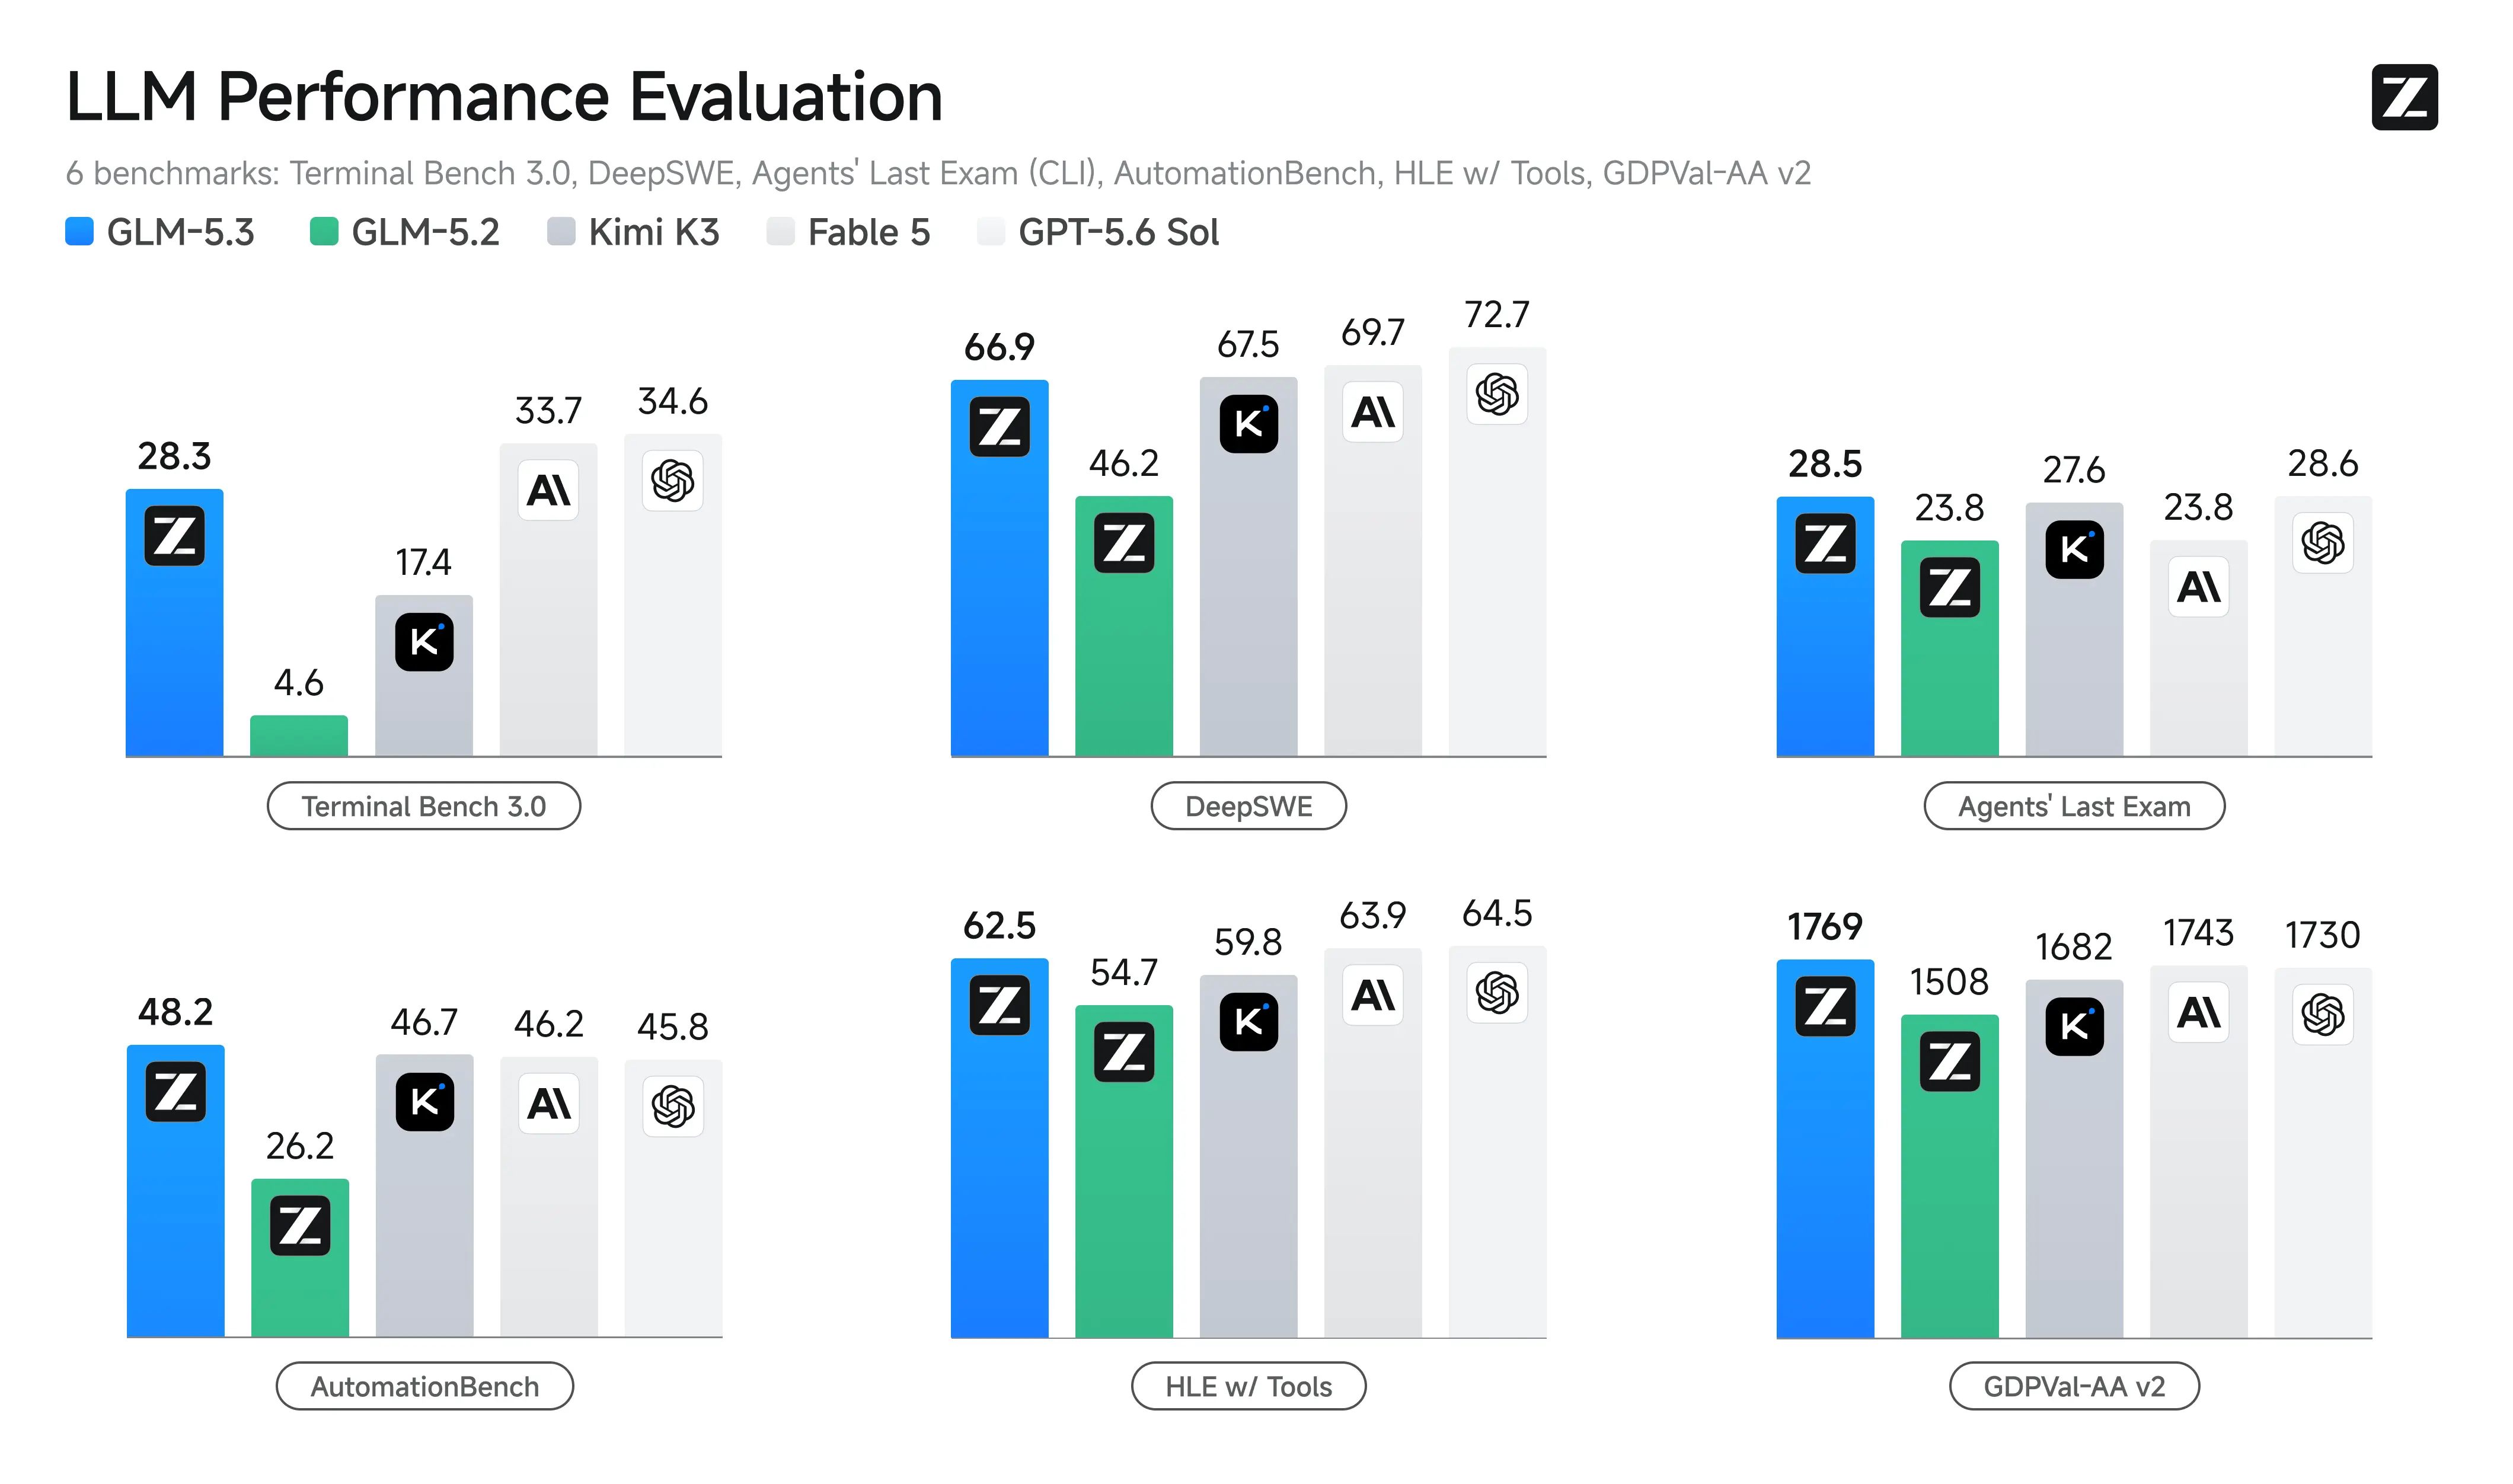
บน Z.ai Code Bench v1.0 ซึ่งเป็น Benchmark ภายในสำหรับ Coding Agent รุ่นใหม่ทำ Accuracy ได้ 34.5% ที่ Max Effort โดยใช้ Output เฉลี่ยประมาณ 75,000 Tokens ต่อ Task เทียบกับ GLM-5.2 ที่ได้ 23.4% และใช้ประมาณ 96,000 Tokens บริษัทสรุปว่าประสิทธิภาพดีขึ้นราว 50% พร้อมใช้ Output Token ลดลง
ตัวเลขนี้น่าสนใจ แต่ต้องอ่านตามขอบเขตของหลักฐาน Z.ai Code Bench เป็นชุดทดสอบภายใน เราตรวจโจทย์ทั้งหมดหรือรันซ้ำเองไม่ได้ การเปรียบเทียบกับโมเดลอื่นยังขึ้นกับ Agent Harness, Context, Effort, Timeout และ Sampling ที่ใช้ด้วย คะแนนจึงเหมาะสำหรับตั้งสมมติฐานว่าจะลองอะไรต่อ มากกว่านำไปสรุปว่าโมเดลหนึ่งชนะทุกงาน
อีกจุดที่ควรดูคือ GLM-5.3 ยังไม่ได้เป็นอันดับหนึ่งในทุกกราฟของผู้พัฒนาเอง บน Z.ai Code Bench รุ่นใหม่ได้ 34.5% ที่ Max Effort ขณะที่โมเดลปิดตัวหนึ่งในกราฟได้ 39.5% ข้อดีของ GLM-5.3 ในกราฟนี้อยู่ที่การขยับเข้าใกล้กลุ่มบนพร้อมใช้ Output Token น้อยลง ไม่ใช่การกวาดทุกอันดับ
Cybersecurity คือทั้งจุดขายและความเสี่ยง
Z.ai เพิ่มข้อมูลและ Environment สำหรับค้นหาช่องโหว่เข้าไปใน Post-training ผลที่ออกมาไม่ได้หยุดอยู่แค่การชี้ตำแหน่ง Bug แต่เริ่มเชื่อมขั้นตอนหลายช่วงของ Exploitation เข้าด้วยกัน
ตัวเลขที่บริษัทเผยแพร่มีดังนี้
| Benchmark | GLM-5.2 | GLM-5.3 | สิ่งที่วัด |
|---|---|---|---|
| CyberGym | 77.2% | 84.5% | ค้นหาและยืนยันช่องโหว่จาก Source Code |
| ExploitBench | 24.4% | 54.4% | ให้เหตุผลเกี่ยวกับช่องโหว่จริงและการ Exploit |
| ExploitGym, 2 ชั่วโมง | 29 Tasks | 105 Tasks | จำนวนงาน Exploitation ภายใต้งบเวลาที่ Normalize แล้ว |
| ExploitGym, 6 ชั่วโมง | 39 Tasks | 130 Tasks | จำนวนงาน Exploitation ภายใต้งบเวลาที่ Normalize แล้ว |
GLM-5.3 ทำคะแนน CyberGym สูงสุดในกราฟของ Z.ai แต่ยังตามโมเดลปิดใน ExploitBench และ ExploitGym อยู่มาก กราฟจึงสื่อว่ารุ่นใหม่โตจากรุ่นก่อนเร็ว โดยเฉพาะขั้นที่ใกล้การ Exploit มากขึ้น ไม่ได้หมายความว่าเก่ง Cyber ที่สุดทุกด้าน
Z.ai ยังระบุว่าหลังให้ทีม Security ตรวจสอบ คัดกรอง และตัดรายการซ้ำ โมเดลช่วยพบช่องโหว่ 2,436 รายการใน 269 โครงการ โดย Security Disclosure Ledger แจกแจง 1,097 รายการเป็นระดับ High และ Critical บริษัทสร้าง Ledger นี้เพื่อติดตามรายการที่เปิดเผยแล้วและรายการที่ยังอยู่ในกระบวนการแจ้งผู้ดูแล
ตัวเลขเหล่านี้เป็นข้อมูลจากผู้พัฒนาและกระบวนการเปิดเผยยังดำเนินต่อ จึงควรใช้คำว่า “Z.ai ระบุ” แทนการเขียนเหมือนทุกช่องโหว่ได้รับ CVE หรือยืนยันจากบุคคลที่สามแล้ว การเลื่อนปล่อย weights เพื่อทำ Hardening เพิ่มเป็นสัญญาณว่าทีมเองก็เห็นความเสี่ยงจาก Dual-use Capability ชุดนี้
ผู้ใช้ API ต้องเปลี่ยนอะไร
GLM-5.3 ใช้ Model ID glm-5.3 และรองรับระดับการคิดสามระดับ
lowสำหรับงานเบาหรือกรณีต้องการลดต้นทุนและเวลาhighสำหรับงานที่ต้องวิเคราะห์มากขึ้นmaxเป็นค่าเริ่มต้น และ Z.ai แนะนำสำหรับ Coding
ตัวอย่างค่าที่ประกาศใช้กับ API:
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "max"
}
บน API ของ GLM-5.3 ไม่รองรับ thinking.type: "disabled" แล้ว หากระบบเดิมปิด Thinking อยู่ ให้เปลี่ยนเป็น enabled และตั้ง reasoning_effort เป็น low ก่อนเปลี่ยน Model ID ไม่เช่นนั้น Request อาจล้มเหลว
เอกสารสำหรับ Coding Agent ระบุพฤติกรรมเพิ่มอีกชั้นว่า Adapter บางตัวจะแปลงค่าที่สื่อถึงการปิด Thinking ให้เป็น low อัตโนมัติ ดังนั้นอย่าเดาจากชื่อ Parameter ควรทดสอบกับ Endpoint และ Agent ที่ใช้งานจริง
ผู้ใช้ GLM Coding Plan ทุกแพ็กเกจเข้าถึง GLM-5.3 ได้แล้ว และ Request ที่อ้าง GLM-5.2 หรือ GLM-5.1 จะถูก Route ไปยัง GLM-5.3 อัตโนมัติ สำหรับ Claude Code สามารถใช้ชื่อ glm-5.3[1m] เมื่อต้องการ Context หนึ่งล้าน Tokens ตามขั้นตอนในเอกสารของ Z.ai
ควรรีบย้ายมาใช้หรือไม่
ถ้าคุณใช้ AI Agent ทำ Refactor หลายไฟล์, แก้ Build, รัน Test และทำงานกับ Tool หลายตัว GLM-5.3 น่าลอง เพราะการฝึกรอบนี้ตั้งใจแก้โจทย์ประเภทนั้นโดยตรง แต่ไม่ควรย้าย Production Workflow จากกราฟ Benchmark เพียงอย่างเดียว
วิธีทดสอบที่ได้คำตอบมากกว่าคือเลือก Task จากงานจริง 10-20 งาน แล้วเก็บข้อมูลอย่างน้อยสี่อย่าง
- Task สำเร็จจริงหรือไม่หลังรัน Test และ Build
- Agent แก้นอก Scope หรือเพิ่ม Dependency โดยไม่จำเป็นหรือไม่
- ใช้เวลาและ Token เท่าไรจนจบงาน ไม่ใช่ดูเฉพาะคำตอบรอบแรก
- เมื่อใช้ Tool หรือทำงานนาน Agent ยังรักษาข้อกำหนดเดิมได้หรือไม่
งานที่เกี่ยวกับ Security ควรรันใน Sandbox จำกัด Network และ Credential พร้อมเก็บ Log ของ Tool Call ทุกครั้ง ความสามารถค้นหาช่องโหว่ที่สูงขึ้นไม่ได้รับประกันว่าโมเดลจะไม่ใช้วิธีเสี่ยงหรือทำเกินขอบเขต
ส่วนผู้ที่รอ Self-host ควรรอ weights, License, System Requirements และผล Safety Evaluation หลังครบช่วงสองสัปดาห์ก่อนตัดสินใจเรื่อง Hardware การประกาศว่าจะเปิด weights ยังไม่บอกว่ารันได้คุ้มบนเครื่องระดับใด
สรุป
GLM-5.3 แสดงให้เห็นว่า Base Model เดิมยังไปต่อได้อีกไกลเมื่อ Post-training มี Environment ที่ยาว ใกล้งานจริง และตรวจผลได้ดี คะแนน Coding กับ Agent ดีขึ้นพร้อม Token Efficiency ที่น่าสนใจ แต่ Benchmark ภายในยังต้องพิสูจน์กับงานของเราเอง
ด้าน Cybersecurity ทำให้รุ่นนี้ต่างจากข่าวอัปเดตคะแนนทั่วไป เพราะความสามารถที่สูงขึ้นมีทั้งประโยชน์ต่อการค้นหาช่องโหว่และความเสี่ยงจากการนำไปใช้โจมตี การที่ Z.ai ชะลอการปล่อย weights เพื่อ Hardening จึงเป็นข้อมูลหลักที่คนประเมินโมเดลควรดูควบคู่กับคะแนน
ถ้าจะทดลอง ให้เริ่มจากงานจริงที่มี Test, จำกัดสิทธิ์ของ Agent และวัดผลตั้งแต่คุณภาพ เวลา ไปจนถึง Token ที่ใช้ แล้วค่อยตัดสินว่า GLM-5.3 เหมาะกับ Workflow ของคุณหรือไม่
Sources
- Z.ai — GLM-5.3: Frontier Coding with Emergent Cyber Capabilities
https://z.ai/blog/glm-5.3
ความคิดเห็น